Google傘下のDeepMindが、社会科学研究に人工知能を応用した論文を発表しました。深層学習(ディープ・ラーニング)でゲームの攻略法を学ぶ人工知能「DQN」(関連記事)や、囲碁のトップ棋士を破り話題になった「AlphaGo」(関連記事)などで知られる同社。今回はAIにゲームをさせて、「囚人のジレンマ」に代表される社会的ジレンマの実験に活用しています。
社会的ジレンマとは、個人の合理的な行動が社会全体にとって合理的ではない状況のこと。例えば、「囚人のジレンマ」は共犯者2人が協力、裏切りの2択を迫られる単純なゲームのような形式で表現されていますが、今回の論文は、より現実に即したアプローチとして「sequential social dilemmas(連続的な社会的ジレンマ)」を提唱。個人間で利害関係が発生する状況をゲーム化している点は従来の方法に似ていますが、そのプレイヤーに人工知能を使って、実際にシミュレーションするのが大きく違うところです。
実験では性能差のある人工知能2種を使い、ビームで一時的に相手をフィールドから除外できるルールのもと、得点になるりんごを取り合う「Gathering」を繰り返しプレイ。りんごが十分あるうちは共存していたものの、少なくなると別のプレイヤーを攻撃するようになったといいます。また、設定が違う場合にプレイヤーの動きがどう変わるのかも調べており、りんごが豊富に出現する「パラダイスのような設定」では他のプレイヤーに攻撃しなくなります。他人と利益を奪い合うようなルールだとしても、それが気にならないくらい資源があれば、ビームを撃つ必要はないというわけです。
一方、獲物を捕まえたプレイヤー、協力したプレイヤーがともに得点できるゲーム「Wolfpack」(他人の獲物を狙うハゲタカのような生物がおり、1人きりだと奪われてしまうという状況をイメージしたルール)では、人工知能は協調的な戦略を学習。このようにルールに合わせて行動を最適化する傾向は、性能の高い人工知能のほうが強かったといいます。
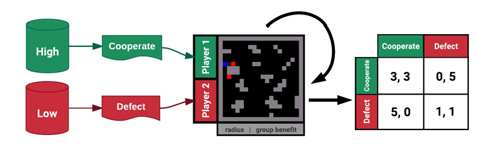
特定の状況をゲームで表現し、人工知能でその実験を行うアプローチ
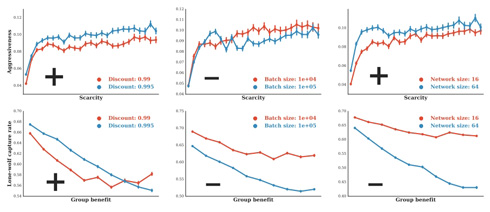
設定を変えて行動要因を調べたり、実験結果を量的なデータとして取り出せたりする点がメリットのようです
論文によれば、「sequential social dilemmas」は経済や交通、環境問題における人間の行動理解、コントロールに役立つとのこと。この手の実証実験を大規模に行おうとすると被験者を集めるのに苦労しそうですし、いくらでも動いてくれる人工知能はなかなか便利なのかもしれません。
(マッハ・キショ松)
コメントランキング
「ほぼ東京なんだよな」 永住したい“千葉県の街”上位に「都内までスイスイ」「色々ちょうど良い」「引っ越す予定はない」の声(6/7) | 千葉県 ねとらぼリサーチ:6ページ目
「ほぼ東京なんだよな」 永住したい“千葉県の街”上位に「都内までスイスイ」「色々ちょうど良い」「引っ越す予定はない」の声(コメント一覧) | 千葉県 ねとらぼリサーチ
「入るのに苦労したが、何倍もの恩恵がかえってくる」 “入学してみたい国立大学”といえば? 女性が選ぶ上位に「目指す価値はある」「毎日良い刺激を受けます」の声(5/6) | 大学 ねとらぼリサーチ:5ページ目
「都内よりも住みやすいかも」 永住したい「東武アーバンパークラインの駅」上位に「適度に栄えていて、飲食店や買い物に不便しない」「大きな商業施設もある」の声(3/3) | 住まい ねとらぼリサーチ:3ページ目
「ラーメン屋に行かなくなった」 最高にうまいと思う「カップ麺」上位に「完全にカップラーメンの概念を塗り替えている」「インスタントとは思えない」の声(2/2) | グルメ ねとらぼリサーチ:2ページ目